[un]prompted.au 2026 - From Diff to Primitive... - Saurabh Kumar
三句話摘要
用 LLM 自動化在 WebKit 中發現記憶體損壞漏洞的四階段系統方案。 多層驗證系統與可執行性篩選比 LLM 專精更有效——自動化結合對抗式驗證才是發現真實漏洞的關鍵。 四階段篩選機制層層降低誤報。準備階段用提交掃描器尋找有趣的改動(安全修補、新 API、複雜變更),建立待審查的文件叢集;尋找階段用 LLM 專注於記憶體問題;挑戰階段用對抗性論證驗證發現的真實性;驗證階段在 ASan mini browser 中執行 POC 確認,只有真正觸發崩潰的才算數。
重點整理
四階段篩選機制層層降低誤報。準備階段用提交掃描器尋找有趣的改動(安全修補、新 API、複雜變更),建立待審查的文件叢集;尋找階段用 LLM 專注於記憶體問題;挑戰階段用對抗性論證驗證發現的真實性;驗證階段在 ASan mini browser 中執行 POC 確認,只有真正觸發崩潰的才算數。
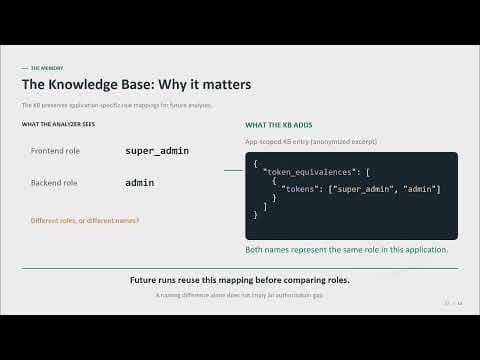
知識庫與向量資料庫是自動化的基礎。講者預先建立了 WebKit 架構威脅模型(程序邊界、IPC、Web 內容進程)和歷史漏洞語義向量資料庫,讓 LLM 能快速找到相關背景知識和過去的類似案例。
挑戰階段的三角色設計有效識別替代執行路徑。在兩個實例漏洞中,辯護人都找到了防護措施,但檢察官隨後發現了繞過方式(WebRTC 漏洞經由編碼轉換流、Transform Stream 漏洞經由 JavaScript 迭代器),展示 LLM 推理替代路徑的能力。
自動化 POC 生成與驗證是關鍵過濾器。系統最多嘗試 10 次產生可執行的 POC,在 ASan mini browser 中實際觸發崩潰才確認漏洞有效,大幅降低了虛假陽性。
實用技巧與重點
- 四階段流程名稱:準備(Prepare)→ 尋找(Find)→ 挑戰(Challenge)→ 驗證(Prove)
- 使用的 LLM 模型:
- 準備階段:GPT 5.4(小型快速模型)
- 尋找階段:Opus 4.6
- 挑戰階段:Opus 4.6 與 GPT 5.5
- 驗證階段:Opus 4.6
- 成果統計:
- 發現總數:8 個記憶體損壞漏洞
- 達到原始驗證:2 個(RTC 堆溢位、Transform Stream 類型混淆)
- 達到驗證前報告:5 個 UAF(use-after-free)
- GPU 進程競態 UAF:2 個
- 自動化工具與資源:
- 提交掃描器與分類器(掃描 WebKit 提交歷史)
- WebKit mini browser ASan 構建
- LLDB 除錯指令碼
- IPS 檔案分析(暫存器、故障位址、堆疊資訊)
- 歷史漏洞向量資料庫
- 檢察官-辯護人-法官三角色系統
- POC 生成參數:最大嘗試次數 10 次
- 漏洞類型範圍:
- 重點:越界存取、生命週期問題、類型混淆
- 排除:DOS、assert/null deref 等簡單漏洞
- 關鍵漏洞特徵:涉及調試檢查(assert、D check)在發布版本中被移除
結論
多層驗證系統與可執行性篩選比 LLM 專精更有效——自動化結合對抗式驗證才是發現真實漏洞的關鍵。
完整解析
講者 Saurabh 是微軟 Edge 瀏覽器安全團隊的安全研究員。他這個週末專案的核心目標是最大化自動化,減少手動干預,使用 LLM 自動發現 WebKit 中的記憶體損壞漏洞。整套系統分為四個階段,每個階段都有明確的篩選目標,逐步過濾虛假發現,確保最後只報告真實可驗證的漏洞。
準備階段負責識別有趣的提交。系統會掃描指定元件目錄的完整提交歷史,用小型 LLM 模型評分。安全修補、新 web API 暴露或複雜改動會獲得高分(例如某次提交獲 18.6 分)。系統考慮多個信號:歷史向量資料庫中是否存在相同領域的先前漏洞報告(WebRTC 有許多歷史漏洞)、改動涉及的檔案數量(22 個檔案表示複雜改動)。高分提交會被轉化為「叢集」——相關檔案的集合——送入下一階段。
尋找階段是 LLM 的首次漏洞獵捕。講者預先編寫了專注於記憶體安全的技能提示,指引 LLM 尋找越界、生命週期問題、類型混淆等特定缺陷。如果 LLM 發現潛在漏洞,系統會啟動一個子代理來驗證可執行性——追蹤程式碼流確認漏洞是否真的可以從外部源(JavaScript)到達內部漏洞點(native 程式碼)。可執行漏洞會被評分並送入挑戰階段。
挑戰階段是系統最創新的部分。講者設計了一個「檢察官-辯護人-法官」三角色對抗框架來過濾虛假陽性。原始發現者扮演檢察官,必須為其發現辯護,提供證據。另一個 LLM 扮演辯護人,試圖駁斥檢察官,在程式碼中尋找執行時檢查、限制或防護措施。法官評估雙方論點,比較程式碼事實,決定哪方正確。這個機制特別有效的例子發生在 WebRTC 漏洞中:辯護人指出 JavaScript 端已有大小限制檢查;檢察官隨後發現了繞過方式,經由編碼轉換流而非直接的 WebRTC 設定。類似地,Transform Stream 漏洞中,檢察官發現可經由 JavaScript 迭代器傳入錯誤類型。這展示了 LLM 在發現替代執行路徑上的優勢。
驗證階段是完全自動化的最後防線。系統將高分發現轉化為 POC 程式碼(JavaScript 或 WebKit 版面測試),在 ASan mini browser 構建中執行。如果 POC 在 10 次嘗試內成功觸發崩潰,漏洞被確認。講者強調,只有實際在 ASan 模式中崩潰的漏洞才被視為真實有效,這就是為什麼虛假陽性大幅下降的原因——從尋找階段的 30-40 個報告,只有通過驗證的漏洞才被報告。
在原始驗證(暫存器控制、任意讀寫)階段,講者介入工作流。他不要求 LLM 一次性產生端到端的完整利用,而是遞進地引導:先驗證能否獲得暫存器控制,再嘗試任意讀寫。每次嘗試失敗時,系統記錄缺失信息,讀取 Apple 自動產生的 IPS 崩潰檔案(包含暫存器狀態、故障位址、回溯資訊),用這些信息引導下一次嘗試。
演講展示的兩個漏洞都很具體。WebRTC 漏洞出現在 Web 內容進程。JavaScript 可以控制 CSRC 中繼資料,程式碼誤用了 push_back:先建立了容量為 N 的向量,再 push_back 了 N 個元素,導致實際有 2N 個元素。WebRTC 側的檢查只在調試版本(D check)中有效,發布版本移除了它,結果是寫入超過固定大小緩衝區。講者用 512 長度的 CSRC 中繼資料觸發了堆溢位,並成功達到暫存器控制。Transform Stream 漏洞涉及類型混淆。本地程式碼期望三個特定型別的物件,但大小檢查只依賴 assert(發布版本移除),且向下轉型沒有型別驗證。JavaScript 迭代器可以傳入錯誤型別,導致虛擬函式呼叫使用損壞資料。兩個漏洞都因調試檢查在發布版本中移除而存在。