[un]prompted.au 2026 -The Fuzzer Reached the Code, yet Missed the State... - Ken Wong
三句話摘要
使用LLM從開發者線索提取狀態資訊,改進JavaScript引擎的模糊測試效率,發現邊界覆蓋無法捕捉的複雜漏洞。 LLM可以從開發者線索中自動提取狀態資訊進行細粒度插樁,使模糊測試能發現需要多個子系統精確互動的漏洞,相比傳統邊界覆蓋效率提升明顯。 邊界覆蓋的局限性:傳統的行覆蓋或邊界覆蓋只記錄代碼是否被執行,但無法區分通過同一代碼路徑、卻處於不同內部狀態的執行。在JavaScript引擎中,相同操作可能遇到不同物件佈局、快取狀態或垃圾回收條件,僅知道到達某行代碼不足以判斷是否探索了相同行為。
重點整理
邊界覆蓋的局限性:傳統的行覆蓋或邊界覆蓋只記錄代碼是否被執行,但無法區分通過同一代碼路徑、卻處於不同內部狀態的執行。在JavaScript引擎中,相同操作可能遇到不同物件佈局、快取狀態或垃圾回收條件,僅知道到達某行代碼不足以判斷是否探索了相同行為。
狀態覆蓋的必要性與挑戰:需要細粒度的狀態觀測來指導模糊測試,但不能盲目記錄所有狀態變化,否則會造成記憶體成本過高和雜訊增加。關鍵在於確定記錄什麼狀態、在代碼的何處記錄。
利用開發者線索的智慧:開發者已在斷言、設計文檔和漏洞報告中隱含地描述了重要的狀態條件。可以使用LLM自動連接這些線索,生成相應的插樁程式碼,避免手動分析海量程式碼。
實驗驗證狀態覆蓋的有效性:在6種JavaScript引擎的測試中,StateLens發現39個漏洞而Libfuzzer僅發現23個,說明狀態覆蓋的額外反饋能有效指導模糊測試器探索更深層的漏洞組合。
實用技巧與重點
- 工具名稱:StateLens
- 使用的LLM:GPT-3.5
- 底層模糊測試框架:Libfuzzer
- 測試配置:72小時執行周期,5次獨立運行取中位數
- 實驗對象:6種JavaScript引擎
- 實驗結果對比:
- Libfuzzer漏洞發現數:23個
- StateLens漏洞發現數:39個
- 增幅:16個漏洞(約70%提升)
- StateLens架構:
- 離線元件:構建開發者產物數據庫(迴歸測試、補丁、文檔),使用LLM進行離線分析
- 在線元件:線上模糊測試迴圈,將提取的狀態資訊作為額外反饋信號
- 案例漏洞:V8中identity map垃圾回收漏洞,程式碼存在於2015年,2021年後變得可利用,涉及共享堆、物件移動和雜湊表狀態記錄。
結論
LLM可以從開發者線索中自動提取狀態資訊進行細粒度插樁,使模糊測試能發現需要多個子系統精確互動的漏洞,相比傳統邊界覆蓋效率提升明顯。
完整解析
講者Ken Wong的研究源於一個實踐性問題:編程代理是否能賺取足夠的錯誤賞金來支付自己的訂閱費用?他首先嘗試讓編程代理在We x CTF中尋找Chrome0day漏洞以獲得10K獎金,但在耗費超過1000美元的token後以失敗告終。這引發了深層思考:既然Chrome每週都在修補大量可利用的漏洞,為什麼自動化代理無法發現?講者意識到根本問題在於,現代可利用的漏洞往往不是孤立的單點代碼錯誤,而是需要引擎多個部分以精確方式相互作用才能觸發的複雜交互。
為了系統地發現這類漏洞,講者轉向模糊測試。在標準的覆蓋引導模糊測試管道中,核心機制是通過執行反饋信號決定保留哪些測試案例用於進一步變異。傳統方法使用結構覆蓋(行覆蓋或邊界覆蓋)作為信號,但這對JavaScript引擎過於粗糙。問題在於,同一行代碼可能在完全不同的內部狀態下執行:物件可能使用快速屬性儲存或慢速字典模式,GC可能已執行或未執行,快取可能熱或冷。講者舉例說明,兩個測試案例可能都經過同樣的代碼路徑(A→B→D),邊界覆蓋記錄完全相同,但它們在中間操作時的內部狀態(X vs Y)卻截然不同。
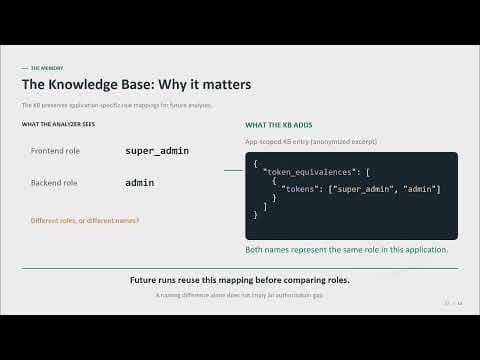
為解決這個問題,講者提出狀態覆蓋(State Coverage)概念,記錄執行時的內部狀態變化作為額外反饋。但挑戰隨之而來:JavaScript引擎有數千種狀態變數,記錄所有變化會造成記憶體爆炸和雜訊。講者的關鍵洞察是,開發者已經在程式碼中留下了重要線索:斷言明確說明代碼期望什麼,註釋解釋設計意圖,補丁和漏洞報告展示期望如何被違反。StateLens工具利用LLM自動分析這些開發者產物,識別重要的狀態資訊,生成精準的插樁程式碼。
講者詳細演示了一個React引擎中map更新的案例。首先從開發者文檔庫查詢相關資訊,LLM篩選出有用的結果。然後進行靜態分析,沿著調用圖追蹤相關函式。最後確定需要觀測的具體物件和狀態。插樁的設計非常謹慎:不修改引擎的實際行為,只在關鍵位置記錄執行前後的狀態,供模糊測試器使用。插樁會檢驗是否引入副作用(如參考計數問題),通過迴歸測試驗證。
講者舉了一個深層案例:V8中identity map在共享堆垃圾回收時的漏洞。這個漏洞涉及當GC移動物件時,雜湊表無法正確追蹤新地址,導致查詢失敗甚至重複插入。漏洞程式碼在2015年就存在,但只有在2021年後的特定執行條件下才變得可利用。StateLens正是通過記錄物件的記憶體區域(共享堆 vs 本地堆)和垃圾回收事件詳情,才能有效指導模糊測試發現這個需要多部分精確互動的漏洞。
實驗結果在6種JavaScript引擎上驗證,StateLens發現39個漏洞相比Libfuzzer的23個,提升明顯。講者強調,雖然使用的LLM(GPT-3.5)可能不夠精準,有時生成的插樁甚至可能導致引擎崩潰,但通過驗證管道修復這些問題後,額外的狀態反饋信號仍能顯著提高漏洞發現效率。LLM的真正價值不在於生成複雜測試案例,而在於幫助決定應測試什麼、模糊測試器應探索哪些狀態組合。